
Контекст для нейросети — это всё, что модель видит в момент ответа: ваш вопрос, история чата, приложенные файлы и инструкции. Чего нет в контексте, того для модели не существует. Поэтому ответ сильнее зависит от того, что вы дали ей заранее, чем от формулировки вопроса.
Мои агенты начинают каждую сессию с одних и тех же файлов. Агент — нейросеть, которая сама выполняет задачи: читает файлы, пишет тексты, запускает программы. Покажу, как они устроены, сколько их и где эта схема у меня ломалась.
- Контекст — рабочая память модели на один ответ. Новый чат стартует с пустой памятью, если к нему не подключены файлы.
- Чем длиннее контекст, тем хуже модель вспоминает детали. Anthropic называет это context rot, «протухание контекста».
- Контекст-инжиниринг решает, что окажется в памяти модели к моменту запроса. Anthropic подробно описала подход 29 сентября 2025 года.
- Постоянный контекст живёт в файлах: about-me, стоп-лист слов, правила проекта, журнал решений. Первый файл собирается за 20 минут.
- Мои правила для агентов лежат в одном файле на 151 строку. Память агента устроена как индекс: одна строка на один факт.
Содержание
- Что такое контекст для нейросети простыми словами
- Контекстное окно: почему нейросеть «забывает»
- Промпт-инжиниринг и контекст-инжиниринг: в чём разница
- Какие слои контекста бывают
- Как собрать свой слой контекста за вечер
- Как это у меня устроено: файлы и второй мозг
- Где это ломалось
- Ошибки, из-за которых контекст не работает
- Частые вопросы
Что такое контекст для нейросети простыми словами
Контекст для нейросети — материал, по которому она отвечает прямо сейчас. Ближе всего сравнение с новым сотрудником в первый день. Он умный, но не знает ни клиентов, ни продукта, ни ваших порядков. Нейросеть в новом чате в том же положении.
Вводного инструктажа у неё нет, есть только текст. Написанное и приложенное модель прочитает. Остальное додумает по среднему, как ответила бы любому человеку с таким вопросом. Отсюда ответы ни о чём и тексты, которые у всех звучат одинаково.
Контекст складывается из нескольких частей:
- системные инструкции от сервиса или ваши, из настроек;
- подключённые файлы и проекты;
- история текущего чата;
- последний вопрос;
- результаты поиска и инструментов, если модель ходила в интернет или в почту.
Промпт, то есть текст запроса, здесь один пункт из пяти. Остальные обычно весят больше.
Контекстное окно: почему нейросеть «забывает»
Контекстное окно — предел того, сколько текста модель удерживает за раз. Документация Anthropic определяет его как весь текст, на который модель опирается при ответе, включая сам ответ. Там же окно названо рабочей памятью модели. Данные, на которых её обучали, в него не входят (Anthropic, Context windows).
Размер окна считают в токенах. Токен — кусочек слова, в таких единицах модель считает текст. У текущих моделей Claude окно до 1 млн токенов, у части моделей 200 тысяч.
Причин у забывания три.
Новый чат. Каждый чат стартует с чистого окна. Вчерашний разговор модель не помнит, если его нет в подключённых файлах или в памяти сервиса.
Переполнение. В длинном чате модели с каждым сообщением уходит вся история целиком. Когда окно заполнено, сервис сжимает старые сообщения или выталкивает их по очереди. Договорённость из начала разговора может просто выпасть.
Протухание. Качество падает и раньше предела. Anthropic пишет прямо: с ростом числа токенов точность и способность вспомнить детали снижаются. В исследовании «Lost in the Middle» учёные Стэнфорда с соавторами показали, что модели лучше используют начало и конец длинного текста. Середина теряется чаще (Liu et al., TACL, 2024).
Для практики вывод простой. Длинный чат на всё подряд работает хуже короткого с хорошими файлами. Одна задача — один чат. Постоянное знание о вас и компании пусть живёт в файлах.
Промпт-инжиниринг и контекст-инжиниринг: в чём разница
Промпт — то, как вы формулируете запрос. Контекстом называют всё, что модель знает к моменту запроса. Промпт-инжиниринг учит писать запрос лучше. Контекст-инжиниринг решает, что вообще должно оказаться в памяти модели.
Подробно подход разобран в статье Anthropic «Effective context engineering for AI agents» от 29 сентября 2025 года. Контекст-инжиниринг там назван набором приёмов: как отобрать и удерживать в памяти модели оптимальный набор информации. Сюда входит и всё, что попадает в память помимо промпта.
Главный принцип оттуда: найти наименьший набор полезных токенов, который сильнее всего повышает шанс нужного результата (Anthropic, 29.09.2025).
В постах я говорю короче: контекст вместо промптов. С апреля по июнь 2026 года я возвращался к этой теме шесть раз. Каждый пост собрал от 101 до 190 лайков, комментариев и репостов. Точнее всего, по-моему, вышло 23 апреля: «Перестать писать длинные промпты. Начать настраивать контекст — один раз, в файлах».
Задачу ставить всё равно придётся: что сделать и как выглядит готовый результат. Поменялась пропорция. Раньше я сидел над идеальной формулировкой. Теперь один раз трачу время на файлы, а запрос пишу в две строки.
| Промпт | Контекст в файлах | |
|---|---|---|
| Где живёт | в одном сообщении | в файлах, которые модель читает в каждом чате |
| Сколько живёт | до конца чата | пока вы его не поменяете |
| Что в нём | задача на сейчас | кто вы, как пишете, правила, решения |
| Кто пишет | вы, каждый раз | вы один раз, дальше правите |
| Когда выбирать | разовая задача | всё, что вы объясняете нейросети второй раз |
Какие слои контекста бывают
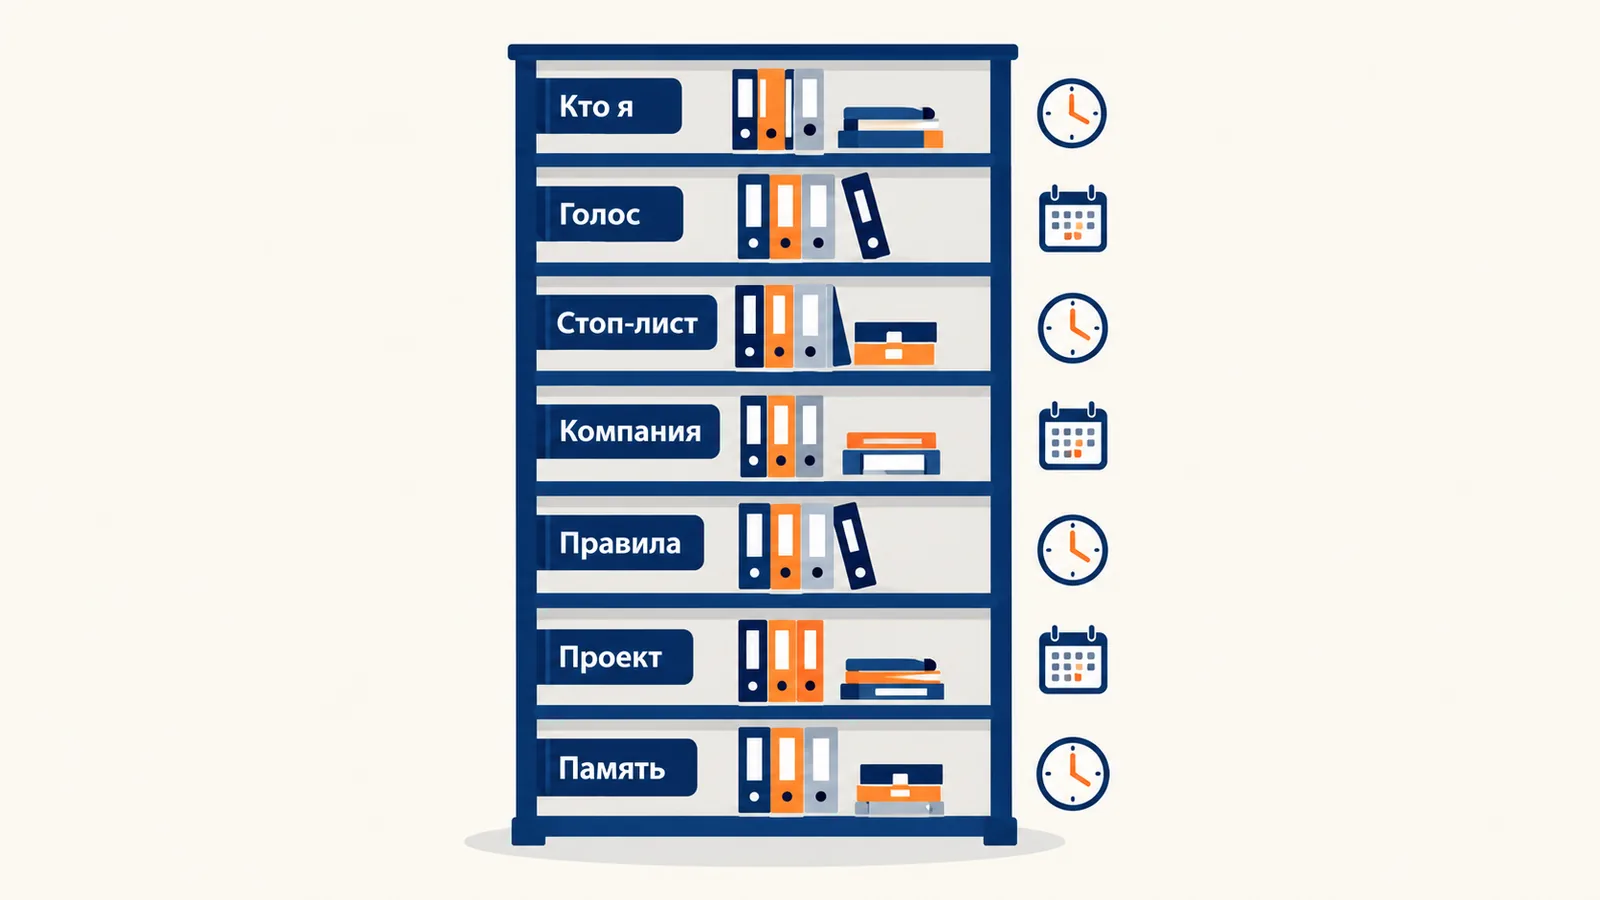
Постоянный контекст удобно держать слоями. Слой — отдельный файл со своим сроком жизни. Голос меняется редко, статус проекта каждую неделю, и обновлять их по отдельности проще.
| Слой | Что в нём | Пример файла | Как часто обновлять |
|---|---|---|---|
| Кто я | роль, компания, чем занят сейчас, цели квартала | about-me.md |
раз в квартал или при смене фокуса |
| Голос | как пишу, 3–5 своих текстов, антипример | раздел «Мои примеры» в about-me.md или voice-profile.md |
раз в 1–2 месяца |
| Стоп-лист | слова и конструкции, которых не должно быть в тексте | anti-ai-writing-style.md |
когда заметили новый штамп |
| Компания | продукт, клиенты, тон бренда, кому говорим «нет» | my-company.md |
раз в квартал |
| Правила работы | что можно, что нельзя, формат ответа, где что лежит | CLAUDE.md или AGENTS.md |
после каждого сбоя |
| Проект | цель, статус, принятые и отвергнутые решения | CLAUDE.md в папке проекта, журнал решений |
раз в неделю |
| Память | факты, которые всплыли в работе | индекс памяти (в Claude Code это MEMORY.md) и файлы рядом |
постоянно, часть записей ведёт сам агент |
| Задача | вход, критерий «готово», образец | сообщение в чате | каждый раз |
CLAUDE.md и AGENTS.md — файлы с правилами, которые агенты Claude Code (от Anthropic) и Codex (от OpenAI) читают в начале каждой сессии.
Для компании у нас есть отдельная карта, гайд «7 слоёв контекста компании». В нём к этим слоям добавлены эталонные задачи на случай смены модели, подключение к CRM и базам через MCP и база знаний с поиском. MCP — стандарт подключения нейросети к внешним системам.
Про скиллы скажу отдельно. Скилл — папка с инструкцией для повторяющейся работы. Контекст отвечает на вопрос «кто я и что у нас происходит». У скилла вопрос другой: «как у нас делается X». Про скиллы у меня есть отдельная статья.
Как собрать свой слой контекста за вечер
Первый слой собирается за вечер, без программирования. Восемь слоёв из таблицы — это потолок, начинать стоит с одного файла. Я делаю так.
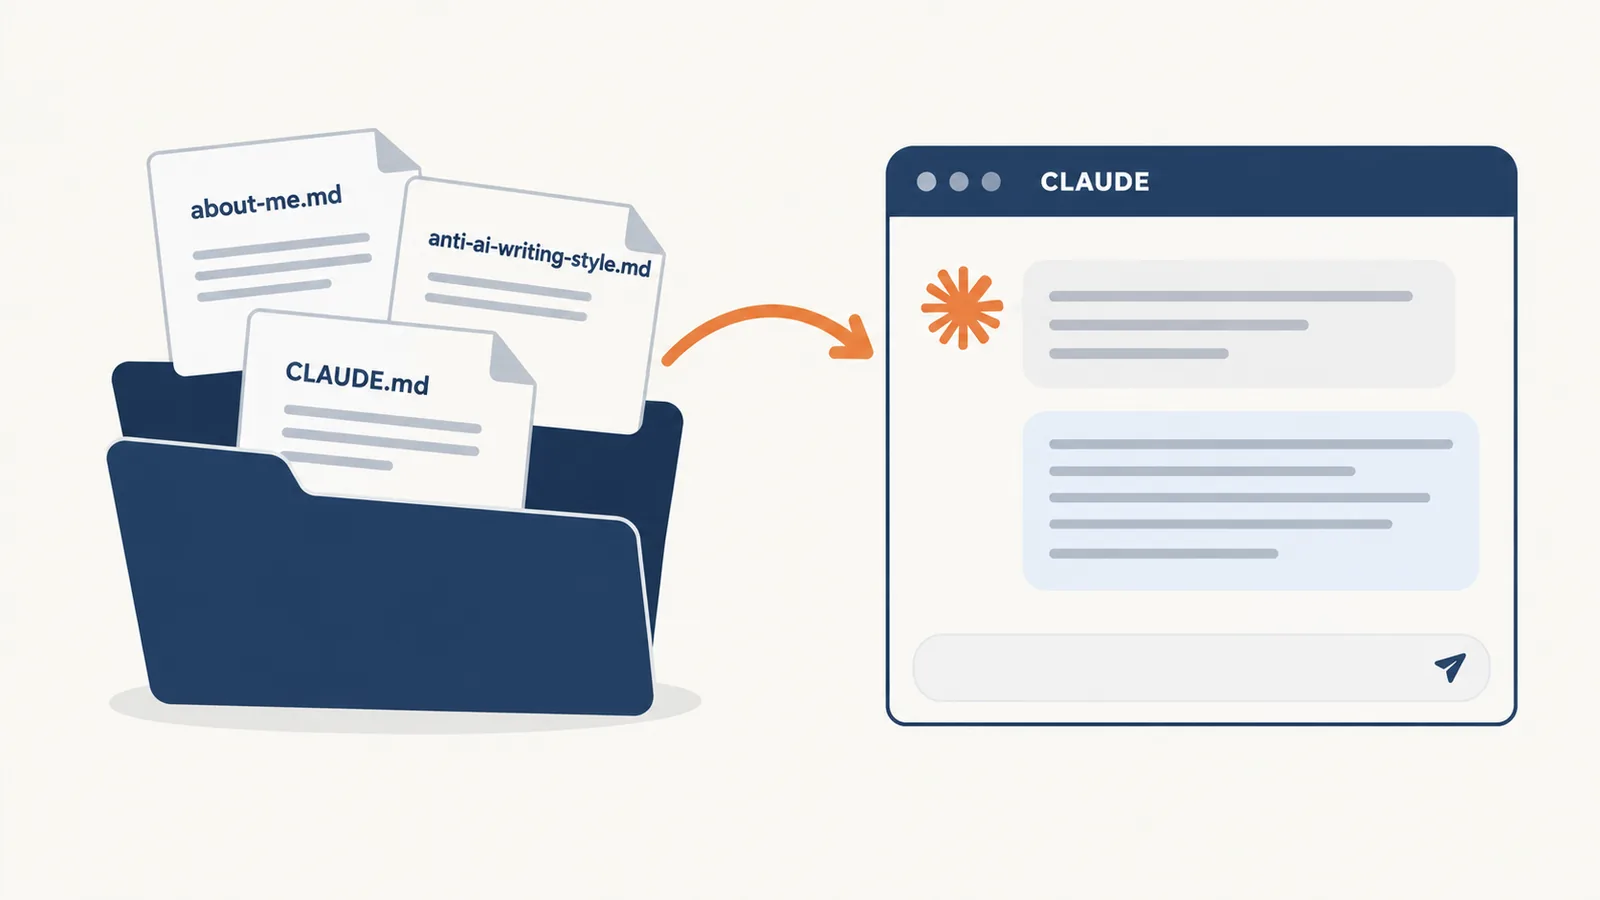
Шаг 1. Заведите папку. В Claude это проект (Projects) или рабочая папка в Cowork, режиме, где Claude работает с файлами на компьютере. В ChatGPT это проект с файлами. Файлы должны подключаться к каждому новому чату сами.
Шаг 2. Соберите about-me через интервью. С чистого листа такой файл пишется тяжело. Проще отдать нейросети список вопросов: «Интервьюируй меня по одному вопросу, потом собери файл about-me.md». В нашем наборе 100 вопросов, ответы занимают около 20 минут.
Шаг 3. Вставьте свои тексты. Этот раздел важнее остальных. Голос модель перенимает по образцам. Прилагательные вроде «пишу просто и по делу» дают ей мало. Хватит 3–5 текстов и одного антипримера.
Шаг 4. Добавьте стоп-лист. В нём слова и конструкции, по которым узнают нейросеть: штампы-усилители, «не просто инструмент», тире через слово. У нас в списке больше 110 пунктов.
Шаг 5. Пропишите общую инструкцию. Она идёт в настройки проекта или в CLAUDE.md:
Перед каждым текстом читай about-me.md и anti-ai-writing-style.md.
Пиши голосом из about-me.md.
После черновика сверься с anti-ai-writing-style.md, перепиши нарушения и покажи список правок.
Факты обо мне бери только из about-me.md, не выдумывай.
Шаг 6. Ставьте задачу по формуле. «Хочу [что сделать]. Готово — это [как выглядит результат]. Сначала прочитай файлы. Если чего-то не хватает, задай вопросы, не угадывай».
Шаг 7. Правьте файл, а не ответ. Модель ошиблась в факте о вас? Исправьте about-me. Ошибку в чате вы завтра увидите снова. Исправленная в файле больше не вернётся.
Скелет about-me, от которого можно оттолкнуться:
# about-me.md

## Кто я
Основатель компании [чем занимаемся — глаголами]. [Сколько человек, рынок].
Сейчас в фокусе: [цель квартала].

## Для кого я пишу
[Роль читателя]. Он знает [что], не знает [что]. Боится [чего].

## Голос
Коротко, с цифрами, от первого лица. На «вы».
Не звучу как: пресс-релиз, тренер личностного роста, нейросеть.

## Слова
Использую: [10 своих слов].
Не использую никогда: [личные стоп-слова сверх общего списка].

## Факты обо мне
- [цифра, кейс, регалия — то, что модель не должна выдумывать]

## Мои примеры
Текст №1: [вставить пост или письмо целиком]
Антипример: [текст, который звучит не как я]
Как это у меня устроено: файлы и второй мозг
Мой рабочий контекст — несколько слоёв файлов, которые агенты читают в начале каждой сессии. Цифры ниже на 5 октября 2026 года.
Начну с правил для агентов. Это один файл на 151 строку, его читают оба моих агента, Claude Code и Codex. У каждого в настройках ссылка на этот же файл, так что правлю я одно место. Внутри запреты на опасные действия, формат ответа, язык и карта, где что лежит.
Документация Claude Code советует держать такой файл короче 200 строк. Длинный занимает больше места в памяти и хуже соблюдается (Claude Code docs).
У проектов свои правила. В папках проектов 78 файлов CLAUDE.md, ещё 19 лежат в репозиториях кода. Агент открывает проект и сразу видит цель, адреса, команды и запреты.
Память агента я держу индексом. Одна строка — один факт, подробности в отдельном файле рядом. Сейчас в индексе около 120 записей, файлов с подробностями больше 180. Claude Code в начале сессии читает только первые 200 строк индекса. Поэтому индекс короткий, а в детали агент заглядывает, когда они нужны.
Голос описан в файле на 153 строки. Его собрали из разбора 4 858 моих сообщений в 14 рабочих чатах. Рядом лежит стоп-лист ИИ-слов, тот самый, что мы раздаём бесплатно.
Под всем этим второй мозг. Это Obsidian, приложение для заметок в обычных текстовых файлах: больше 16 тысяч заметок, всё под git, системой версий. Сам по себе второй мозг только хранит знания. Контекстом его делают файлы-указатели: карта, индекс памяти, CLAUDE.md проекта. По ним агент понимает, что из 16 тысяч заметок читать под конкретную задачу.
В сентябре я собрал ещё контекст-пакет «Егор» для нового ИИ. Это 14 файлов: кто я, продукты, аудитории, голос, хронология, уроки. Из них собраны две склейки, короткая примерно на 55–60 тысяч токенов и полная примерно на 150 тысяч. Первое правило пакета: цифры только с источником. Если источники расходятся, модель спрашивает меня и сама не выбирает.
Вместе со скиллами и привычками это складывается в то, что я называю личной AI-OS: слой поверх любой модели, который помнит за тебя. Модель можно сменить. Файлы останутся.
Где это ломалось
Сломалось не там, где я ждал. Файлы модель читает хорошо. Проблемы начинаются, когда файлов много и их правила спорят.
В одном файле написано «отвечай коротко», в другом «объясняй подробно». Модель выбирает наугад, и от чата к чату поведение плавает. Лечится порядком приоритетов: какой файл главнее и что делать по умолчанию. Например, «по умолчанию коротко, развёрнуто только по просьбе».
Вторая история — устаревание. Файл сам не учится. Это инструкция, которую модель каждый раз читает заново, ровно в том виде, в каком вы её оставили. Цель квартала поменялась, в about-me осталась старая, и модель честно работает на прошлый квартал.
Третья история про набор «7 шагов, чтобы Claude писал как ты». Внутри два файла, about-me и стоп-лист, плюс одна общая инструкция. В посте про этот набор я написал: «Редактура падает с часа до десяти минут». Это мои ощущения, замера не было.
Главную работу там делает раздел с живыми примерами. Без него модель знает о вас всё и всё равно пишет чужим голосом.
Ошибки, из-за которых контекст не работает
Чаще всего контекст ломается по одной из шести причин.
- Всё в одном бесконечном чате. Окно заполняется, старое вытесняется, середина теряется. Новой задаче нужен новый чат.
- Каждое утро пересказывать себя: «Я предприниматель, у меня компания X…». Файл about-me закрывает это один раз.
- Файл из одних прилагательных. «Пишу живо и по делу» модели почти ничего не говорит, три своих текста скажут больше.
- Свалить всё подряд: сырые PDF на сотни страниц, все документы компании разом. Anthropic советует обратное, наименьший набор полезной информации под задачу.
- У файлов нет владельца. Через месяц about-me устарел, правила противоречат друг другу. Назначьте ответственного, хотя бы себя, и пересматривайте файлы раз в неделю.
- Надежда, что модель запомнит сама. Память сервиса помогает, но что в ней лежит, вы не видите. Всё нужное держите в файле, который можно открыть и поправить.
Частые вопросы
Что такое контекст для нейросети простыми словами?
Контекст для нейросети — это всё, что она видит в момент ответа: ваш вопрос, история текущего чата, приложенные файлы, системные инструкции и результаты поиска. Модель отвечает только по этому материалу и своим общим знаниям.
Чего нет в контексте, того для неё не существует. Поэтому одна и та же модель отвечает точнее, если заранее знает, кто вы, чем занимаетесь и какой результат вам нужен.
Что такое контекстное окно нейросети?
Контекстное окно — это предел текста, который модель удерживает за один раз, включая собственный ответ. Anthropic называет его рабочей памятью модели.
Размер окна считают в токенах, кусочках слов. У текущих моделей Claude окно доходит до 1 млн токенов. Большое окно качества не гарантирует: с ростом объёма модель хуже вспоминает детали, особенно из середины текста. Короткий и точный контекст работает лучше.
Почему нейросеть забывает, о чём мы договорились?
Причин три. Новый чат начинается с чистой памяти. В длинном чате старые сообщения вытесняются, когда окно заполнено. И даже до предела модель хуже держит детали из середины длинной переписки. Договорённости выносите в файл проекта или в about-me, а под каждую задачу открывайте новый чат. Тогда модель прочитает правила заново в самом начале.
Чем контекст-инжиниринг отличается от промпт-инжиниринга?
Промпт-инжиниринг учит формулировать запрос. Контекст-инжиниринг решает, что окажется в памяти модели к моменту запроса: файлы о человеке и компании, правила, история решений, данные из систем. В статье от 29 сентября 2025 года Anthropic назвала контекст-инжиниринг естественным развитием промпт-инжиниринга. Промпт остаётся частью контекста, но перестаёт быть главным рычагом качества.
Что написать в файл about-me для нейросети?
В about-me пишут то, что нейросеть иначе додумает: кто вы и чем заняты сейчас, для кого пишете, как звучит ваш голос, какие слова вы используете и каких избегаете. Добавьте факты о себе, которые модель не должна выдумывать.
Самый полезный раздел — 3–5 ваших живых текстов и один антипример. Быстрее всего собрать файл через интервью: попросите нейросеть задавать вопросы по одному и сложить ответы в профиль.
Как связаны контекст и система второго мозга?
Второй мозг — система заметок, где человек хранит знания, например в Obsidian или Notion. Сам по себе он нейросети не помогает: тысячи заметок в окно не поместятся.
Контекстом второй мозг становится через файлы-указатели. Карта папок, индекс памяти с одной строкой на факт и инструкции проекта подсказывают модели, что читать под конкретную задачу. Так у Егора Рудомёткина устроено хранилище больше чем на 16 тысяч заметок.
Сколько контекста давать нейросети?
Столько, сколько нужно для задачи, и не больше. Anthropic формулирует принцип так: найти наименьший набор полезной информации, который сильнее всего повышает шанс нужного результата. Лишний текст расходует внимание модели и портит ответы. Начните с одного файла about-me и короткой инструкции. Новый файл добавляйте, когда ловите себя на том, что объясняете модели одно и то же второй раз.