Эффективность внедрения ИИ измеряют по договорённости, которую записали до старта пилота. В неё входят главная метрика, точка отсчёта «до», окно замера и кто подтверждает результат. Без неё один пилот можно показать прибыльным, убыточным и нулевым. Ниже 24 метрики и таблица выбора.
Я Егор Рудомёткин — AI-стратег, спикер по ИИ и эксперт по AI-агентам, основатель AI-Cofounder School и AI-Teams. У меня 7 AI-проектов в 5 отраслях. Я часто встречаюсь со специалистами внутри компаний. Им нужен материал для руководства про эффект, цену и безопасность.
- Результат пилота зависит от того, что договорились считать. По часам выходит прибыль. По вложениям в инфраструктуру выходит убыток, по выручке ноль.
- По опросу «Интеллектуальной аналитики» (2026), до промышленной эксплуатации дошли около 7–10 % пилотов генеративного ИИ, запущенных в 2025 году.
- Метрики пилота укладываются в 24 пункта и пять групп: финансовые, операционные, клиентские, кадровые и контрольные.
- На один пилот хватает одной главной метрики и одной контрольной. Остальные 22 подождут.
- Деньги считают по полной стоимости. По KPMG (2026), доказанный возврат вложений в ИИ есть у 15 % компаний, которые видят все затраты. У остальных он есть у 3 %.
Содержание
- Что такое эффект от внедрения ИИ
- Один пилот — три отчёта: прибыль, убыток, ноль
- Что договориться считать до старта пилота
- 24 метрики пилота в пяти группах
- Какую метрику брать под цель пилота
- Как посчитать деньги без самообмана
- Как это было у меня: программа у оператора связи
- Где у меня самого нет базы «до» и где цифры врали
- Ловушки и когда эффект честно не измерить
- Частые вопросы
Что такое эффект от внедрения ИИ
Эффект от внедрения ИИ — это измеримая разница между работой с ИИ и без него на одной и той же задаче. Её меряют в деньгах, времени, качестве или рисках.
Я делю эффекты внедрения ИИ на пять видов:
- прибыль: выросла выручка или маржа на конкретном продукте;
- экономия: упали прямые затраты по одной статье расходов;
- скорость: весь цикл задачи стал короче;
- качество: меньше ошибок, выше оценка клиента;
- риски: меньше утечек, сбоев и решений без проверки.
Чаще всего путают два вида экономии. Первый называют hard savings, жёсткая экономия. Её видно в бухгалтерии: отменили подрядчика, отказались от лицензии, сократили ставку.
Второй вид, soft savings, мягкая экономия. Это высвобожденное время. Люди тратят на задачу меньше часов. В отчёт о прибылях эти часы попадут, только когда уйдут в новую работу.
Поэтому про сэкономленные часы я всегда спрашиваю, на что они пошли. Нет ответа — денег тоже нет. В списке ниже это пара: №02 «снижение прямых затрат» и №08 «высвобождённое время».
Один пилот — три отчёта: прибыль, убыток, ноль
Один и тот же пилот по ИИ честно показывает три разных результата. Какой из них попадёт в отчёт, решает выбранная метрика. В мае я написал об этом пост:
Засчитал сэкономленные часы — прибыль. Засчитал инвестиции в инфраструктуру — убыток. Засчитал выручку — ноль. И всё это правда. Результат зависит не от ИИ. От того, что договорились считать.
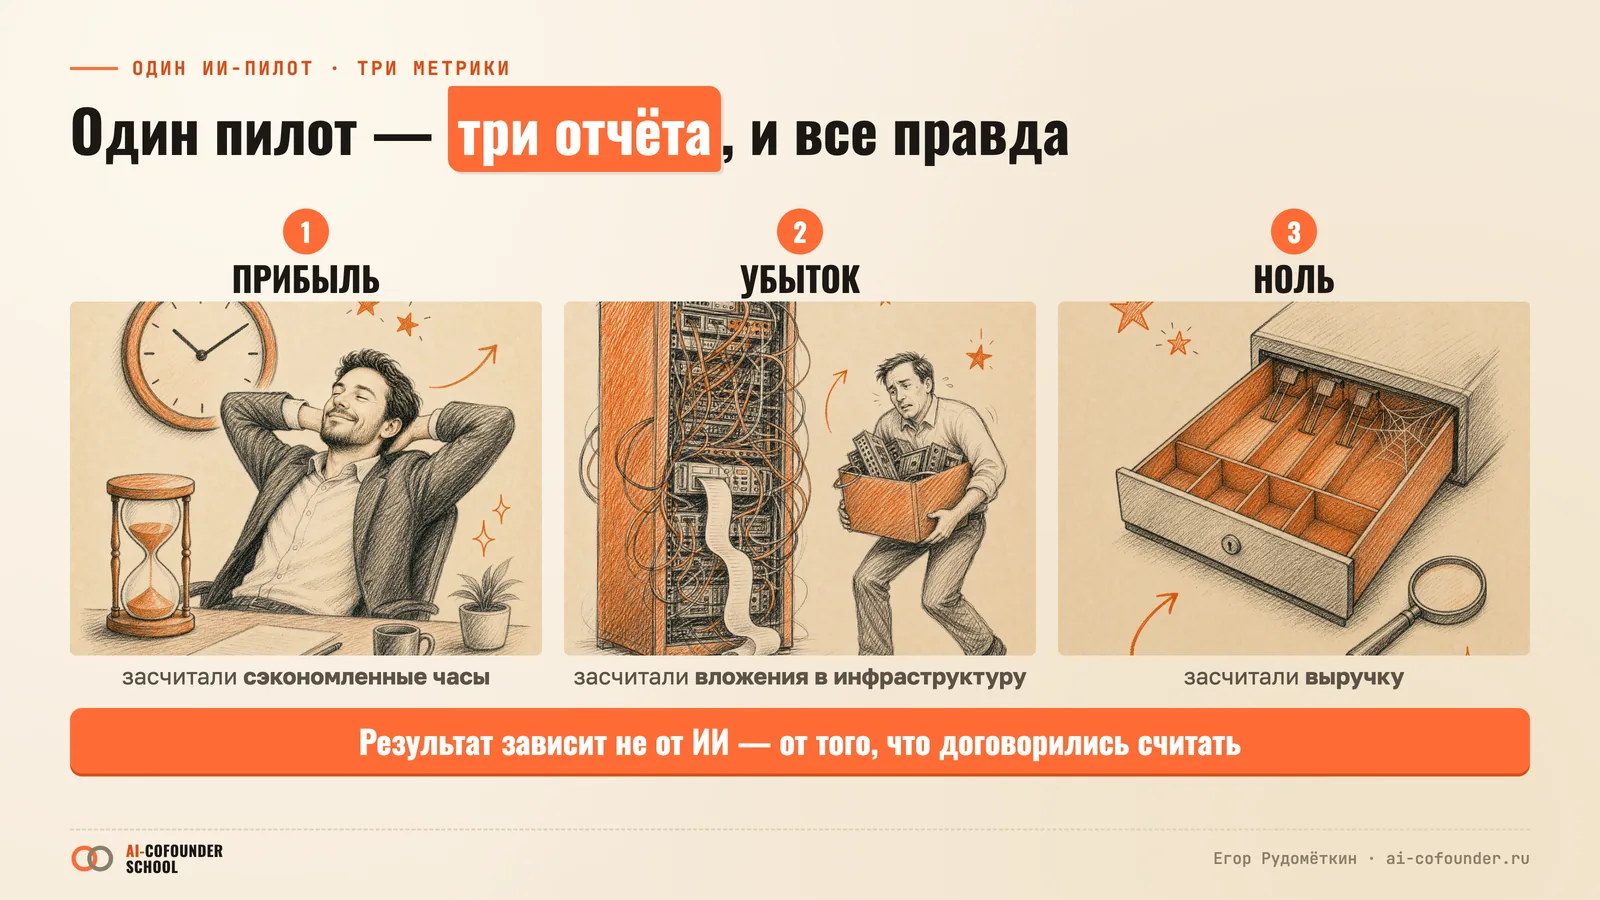
Сценарий потом один и тот же. Заказчик спрашивает: «А где деньги?» Команда ищет цифру с положительной динамикой. На ней пилот доживает до второго года. Потом его тихо закрывают: «не оправдал ожиданий». Хотя ожидания так никто и не записал.
По России есть цифры. Это опрос «Интеллектуальной аналитики» (CNews, 2026) среди крупных компаний. До промышленной эксплуатации дошли около 7–10 % пилотов генеративного ИИ 2025 года.
Ещё 30–40 % пилотов свернули, потому что ожидаемого финансового эффекта они не дали. Считали именно пилоты, не компании. Главная причина, по данным опроса, — слабая встройка ИИ в бизнес-процессы.
Вряд ли во всех этих пилотах сломался сам ИИ. В моих проектах чаще было другое: никто заранее не записал, какой результат считать успехом.
Что договориться считать до старта пилота
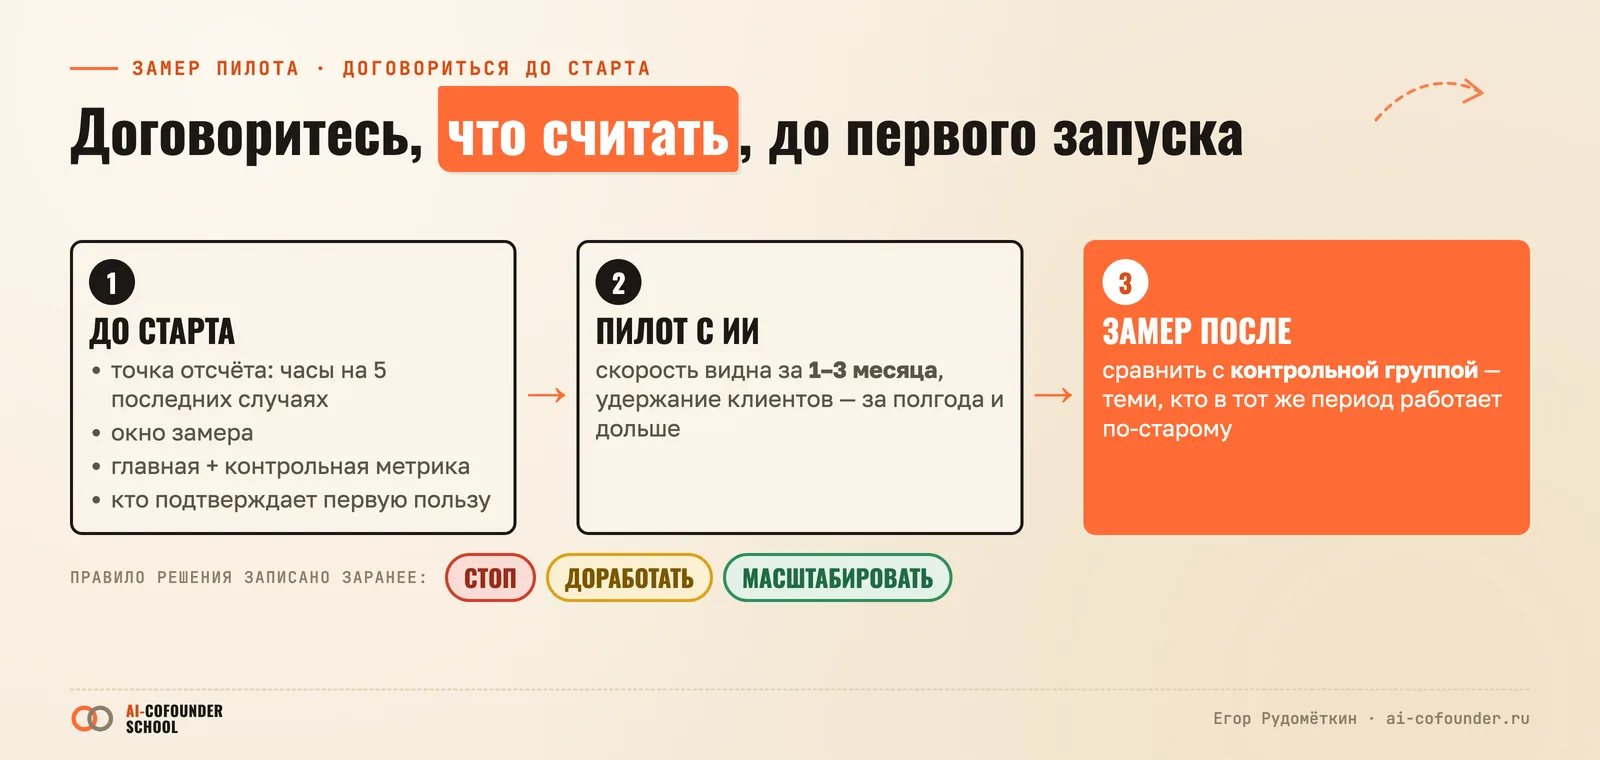
До старта договариваются о пяти вещах: точка отсчёта, окно замера, главная метрика, кто подтверждает первую пользу и правило решения.
- Точка отсчёта. По задаче записывают, сколько часов заняли пять последних случаев и сколько раз в месяц её делают. По-английски это baseline. Без него через два месяца спорить не о чем.
- Окно замера. Срок, после которого смотрим цифры. Скорость видна за 1–3 месяца, удержание клиентов за полгода и дольше.
- Одна главная метрика и одна контрольная. Главная отвечает на цель. Контрольная ловит самообман: например, рост скорости ценой ошибок.
- Кто подтверждает первую пользу. Заранее решают, какое событие считается первой пользой. Например, сотрудник закрыл с ИИ первую настоящую задачу. И кто это подтверждает.
- Правило решения. Какие цифры значат «стоп», какие «доработать», какие «масштабировать».
Про последний пункт пишет и OECD. В докладе о пилотах генеративного ИИ в госсекторе (2026) пилот оценивают по пяти направлениям. Это производительность, ценность, реализуемость, удобство и риски.
Критерии, пороги, сроки и решения «стоп, доработать, масштабировать» там фиксируют до старта. Доклад написан для государства. Для бизнеса логика та же.
24 метрики пилота в пяти группах
Метрики пилота делятся на пять групп: финансовые, операционные, клиентские, кадровые и контрольные. Я свёл их в одну карту. В кадровой группе четыре метрики, в остальных по пять. Под каждой метрикой записал, где на ней обычно ошибаются.
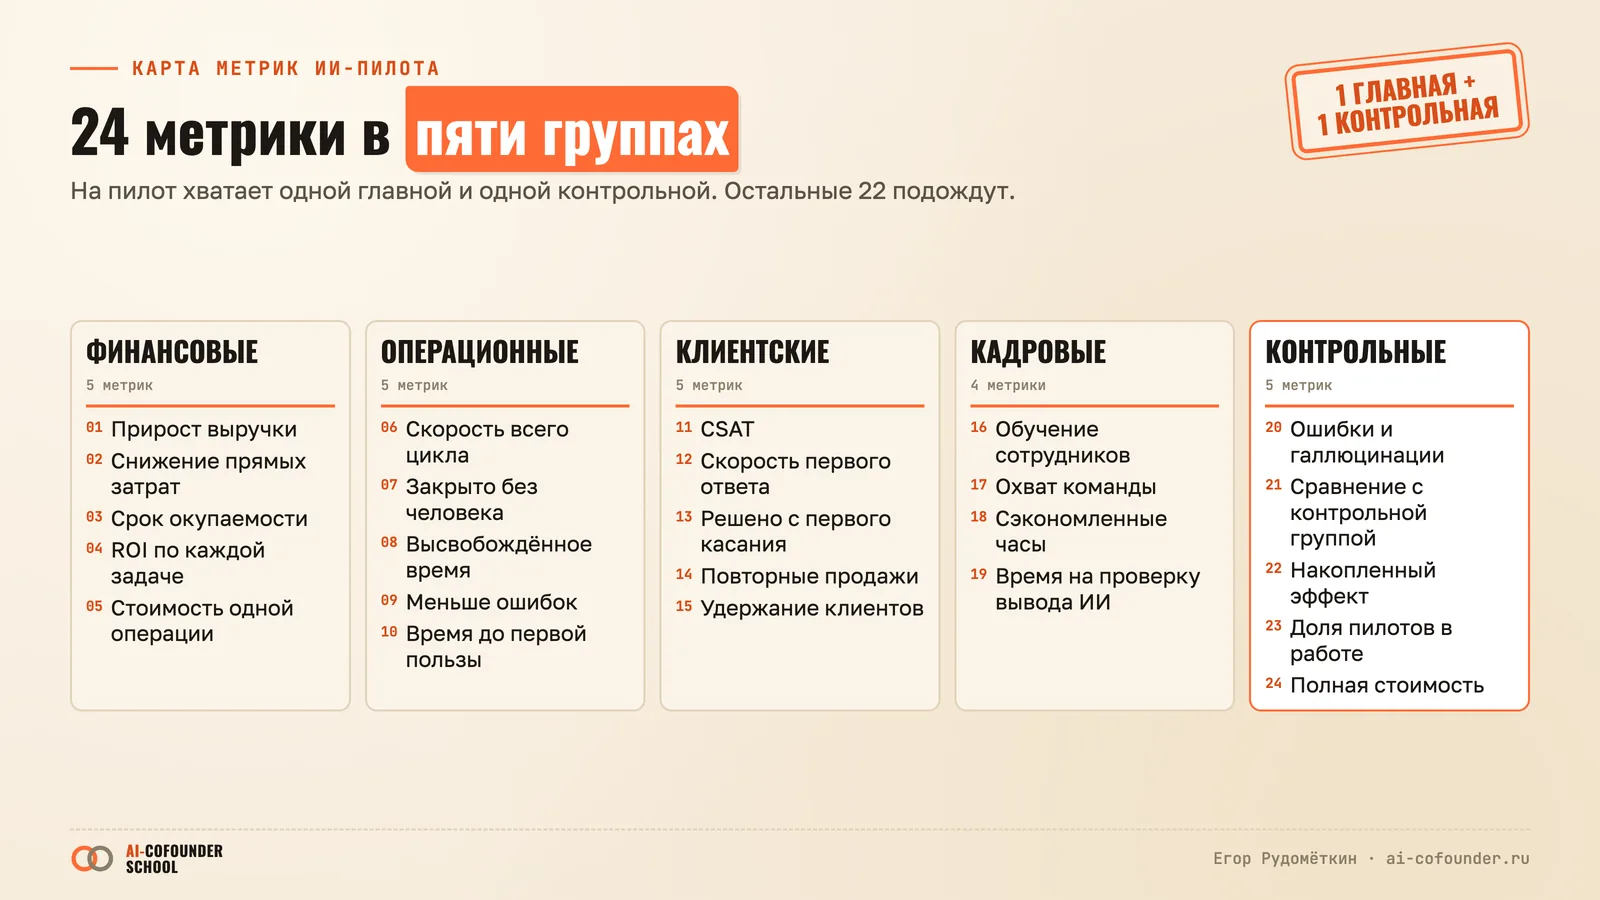
Брать все 24 сразу не надо. В таблицах коротко: что считать и где ловушка.
Финансовые
| № | Метрика | Что считать | Ловушка |
|---|---|---|---|
| 01 | Прирост выручки | выручка группы с ИИ против группы без ИИ за одинаковый период | эффект ИИ путают с сезоном, новой рекламой, сменой команды |
| 02 | Снижение прямых затрат | разница по одной статье: ФОТ поддержки, цена документа, подрядчик | часы выдают за деньги, хотя ФОТ не изменился |
| 03 | Срок окупаемости | вложения, делённые на ежемесячную чистую выгоду | забывают интеграцию, обучение и поддержку после пилота |
| 04 | ROI, возврат вложений | (выгода − вложения) / вложения × 100 % по каждой задаче отдельно | средний ROI по портфелю прячет убыточные задачи |
| 05 | Стоимость одной операции | (лицензии + токены + время проверки + инфраструктура) / число операций | токены и время человека на проверку не учитывают |
Операционные
| № | Метрика | Что считать | Ловушка |
|---|---|---|---|
| 06 | Скорость всего цикла | время цикла до и после на одном типе задач | меряют только шаг ИИ, ручная передача дальше съедает выигрыш |
| 07 | Закрыто без человека | задачи, закрытые ИИ без эскалации, к числу всех задач | «ИИ коснулся» засчитывают как «ИИ закрыл сам» |
| 08 | Высвобождённое время | сэкономленные часы и доля часов, ушедших в новую работу | часы без новой работы деньгами не становятся |
| 09 | Меньше ошибок | ошибки до и после по типу, определённому заранее | определение ошибки сужают задним числом, новые ошибки ИИ не считают |
| 10 | Время до первой пользы | дата первого измеримого эффекта минус дата старта | считают от релиза модели, хотя важна польза сотруднику |
Клиентские
| № | Метрика | Что считать | Ловушка |
|---|---|---|---|
| 11 | CSAT, удовлетворённость клиента | средняя оценка отдельно в обращениях с ИИ и без него | общий CSAT без отметки «ИИ участвовал» |
| 12 | Скорость первого ответа | время до первого осмысленного ответа, медиана | автоприветствие засчитывают как ответ |
| 13 | FCR, решено с первого касания | закрытые за один контакт к числу всех обращений | клиент пишет снова через день; мерить с лагом 7–14 дней |
| 14 | Повторные продажи | клиенты с двумя и более покупками к числу всех | рост рынка и сезон выдают за эффект ИИ |
| 15 | Удержание клиентов | (активные на конец − новые) / активные на начало | ИИ-функции достаются самым активным клиентам |
Кадровые
| № | Метрика | Что считать | Ловушка |
|---|---|---|---|
| 16 | Обучение сотрудников | доля прошедших обучение в целевой роли | «прошли курс» путают с «применяют в работе» |
| 17 | Охват команды | активные пользователи (3+ раза в неделю) к числу сотрудников роли | число купленных лицензий выдают за охват |
| 18 | Сэкономленные часы сотрудника | разница часов × объём в неделю по логам и хронометражу | опора только на самоотчёт |
| 19 | Время на проверку вывода ИИ | время проверки и доводки к общему времени задачи с ИИ | эту метрику не меряют вовсе |
Контрольные
| № | Метрика | Что считать | Ловушка |
|---|---|---|---|
| 20 | Ошибки и галлюцинации ИИ | ответы с ошибкой к числу всех в выборке, которую проверил эксперт | меряют на старте и забывают после смены модели или инструкции |
| 21 | Сравнение с контрольной группой | (метрика с ИИ − метрика без ИИ) / метрика без ИИ | контрольную группу берут из отстающих |
| 22 | Накопленный эффект | динамика на 3, 6 и 12 месяцах | замер на первом месяце хоронит медленные эффекты |
| 23 | Доля пилотов в работе | пилоты, живые через 6 месяцев, к числу всех пилотов | засчитывают выпущенные проекты, которыми никто не пользуется |
| 24 | Полная стоимость использования | все расходы на ИИ: лицензии, токены, интеграция, обучение, контроль | считают только лицензии |
Два термина поясню. Галлюцинация в метрике №20 — уверенный ответ ИИ с выдуманным фактом. Контрольной группой в №21 я называю людей или филиалы, которые в тот же период работают по-старому.
Какую метрику брать под цель пилота
Главную метрику выбирают по цели пилота. Контрольную подбирают под главный риск этой цели. Я пользуюсь вот такой таблицей.
| Цель пилота | Главная метрика | Контрольная | Когда смотреть |
|---|---|---|---|
| Снизить цену операции | №05 стоимость операции | №19 время на проверку | через 3 месяца после стабилизации |
| Ускорить процесс | №06 скорость всего цикла | №09 ошибки | 1–3 месяца |
| Разгрузить людей | №08 высвобождённое время | №18 часы по логам и хронометражу | 1–3 месяца |
| Поддержка без роста штата | №07 закрыто без человека | №13 FCR с лагом 7–14 дней | 3–6 месяцев |
| Качество обслуживания | №11 CSAT в обращениях с ИИ | №21 контрольная группа | 3–6 месяцев |
| Рост выручки | №01 прирост выручки | №21 контрольная группа | от 6 недель в малом бизнесе, 6–12 месяцев в крупном |
| Освоение ИИ командой | №17 охват | №16 обучение плюс активное использование | 3–6 месяцев |
| Решение по портфелю пилотов | №04 ROI по каждой задаче | №24 полная стоимость | раз в год |
Бывает, что цель пилота в одну строку таблицы не влезает. Тогда я сначала сужаю задачу и только потом выбираю метрику.
Как посчитать деньги без самообмана
Деньги пилота считают по полной стоимости, вместе со временем на проверку. Без этого ROI получается красивым только на слайде. ROI, возврат вложений, считают так: (выгода − вложения) / вложения × 100 %.
Начинаю с полной стоимости, это метрика №24. В неё входят лицензии, токены, интеграция, обучение людей и контроль. KPMG Global AI Pulse за второй квартал 2026 года опросил 2 145 руководителей. У компаний, которые полностью видят затраты на ИИ, доказанный возврат вложений есть у 15 % из них. У остальных у 3 %.
Цену одной операции, метрику №05, я считаю на своих агентах. Перед встречей агент собирает мне данные о человеке из LinkedIn. Выходит примерно $0,04 и 35 секунд. Умножил на объём и видишь, во что обойдётся масштаб.
Про время на проверку, метрику №19, забывают чаще всего. Сотрудник полчаса перепроверяет ответ ИИ? Эти полчаса идут в «часы после». Иначе выигрыш завышен.
Сам я свожу пилот к трём цифрам:
- Точка отсчёта. Часы на задачу по пяти последним случаям и сколько раз в месяц её делают.
- Часы после и деньги в месяц: (часы до − часы после) × задач в неделю × ставка часа × 4.
- Качество. Сколько ответов ИИ из скольких верны на прогоне 10–30 реальных примеров. Оценивает человек, который делает эту работу сам.
Выигрыш меньше 15 % — задачу не масштабирую, беру следующую. План замера на 90 дней я подробно разбирал в статье как внедрить ИИ в компанию.
Как это было у меня: программа у оператора связи
У оператора связи итог был такой: 6 из 8 проектов можно доказать за две недели. Восемь проектов с ИИ подготовили команды сотрудников за время программы внедрения.
До этого вывода мы дошли на разборе перед защитой. Мы шли по расчётам эффекта. Строки «прогнали, вот результат» не нашлось ни в одном. Эффект посчитали на бумаге. Результата прогона на настоящем ИИ в расчётах не было.
Главный вопрос жюри на защите: «Вы это пробовали?» Бумажный расчёт на него не отвечает. Поэтому доклады мы пересобрали. На каждый осталось пять пунктов: один проект, один спикер, одна цифра, один прогон, одна просьба. Что в пять пунктов не влезло, уехало в запасные слайды.
Пилоты команды поставили на конец года. Результатов у меня пока нет.
Какие задачи руководителю отдать ИИ, а какие оставить себе, я разбирал в статье ИИ для руководителя.
Где у меня самого нет базы «до» и где цифры врали
У меня самого есть процессы без точки отсчёта. Там я эффект доказать не могу.
Первая история с заводом контента. Так я называю конвейер, где агенты собирают и разбирают посты. Собрали 8 493 поста и получили итог. В тот же день отдельный агент-анализатор перепроверил этот итог и опроверг 6 выводов.
Покажу два из шести. В итоге стояло «рынок вырос втрое». Замера под этим не было, постов мы просто собрали в 20 раз больше. Находок на 100 постов при этом стало меньше: 2,3 запуска вместо 4,5. Ещё был вывод про «медиану цены». В 14 постах из 17 за ней оказался промокод.
Вторая история про контроль, метрика №20. 33 дня мой личный агент стоял. Статус всё это время горел зелёным. Внутри сидела заглушка вместо токена и сыпались 283 ошибки в сутки. Пока ошибки никто не считал, зелёный статус мне ничего не говорил.
Третья про базу «до». Видео я монтирую по тексту своим инструментом. По ощущениям, ручная чистка раньше занимала от получаса до часа. Замера «было» у меня нет. Значит, это заявление, цифрой его не назовёшь.
Сколько часов в неделю экономит вся моя система агентов, я тоже не замерял. Поэтому фразу «экономлю N часов» не пишу. Про агентов и их цену подробнее в статье ИИ-агенты для бизнеса.
Бывает и у клиентов. Один отечественный завод прислал нам логику процесса, а данных к ней не дал. Количества компонентов нет, техпроцессы пустые, часов сборки нет. Точку отсчёта из такого не построить. Эффект потом тоже не доказать.
Ловушки и когда эффект честно не измерить
Эффект честно не измерить в шести ситуациях. Их стоит назвать до старта. После пилота это звучит как оправдание.
- Короткий пилот. Удержание и повторные продажи видны через 6–12 месяцев. Замер на первом месяце их хоронит.
- Нет базы «до». Часы не записали, ошибки не считали. Сравнивать не с чем.
- Процесс поменялся. Вместе с ИИ сменили регламент, команду или рекламу. Чей это эффект, уже не разобрать.
- Самоотчёт. Люди плохо оценивают своё ускорение.
- «Коснулся» вместо «закрыл». Задачу, которой ИИ коснулся, засчитывают как закрытую им. Доля эскалаций пропадает из отчёта.
- Контрольная группа из отстающих. Филиал с ИИ сравнивают со слабым филиалом, и эффект раздувается.
Про самоотчёт есть замер. В исследовании METR (2025) опытные разработчики решали задачи с ИИ на 19 % дольше. Сами они при этом считали, что ускорились примерно на 20 %.
В феврале 2026 года METR написал, что сейчас ИИ, вероятно, ускоряет разработчиков сильнее, чем в начале 2025-го. Самооценку ускорения он снова назвал ненадёжной. Так что ощущению скорости я без замера не верю.
Пример есть и у меня. В июне я писал, что редактура сократилась с часа до десяти минут. Это ощущение, замера не было. Для метрики №18 такая цифра не годится.
Частые вопросы
Как оценить эффективность внедрения ИИ?
Эффективность внедрения ИИ оценивают сравнением с точкой отсчёта, записанной до пилота. По задаче фиксируют часы на пять последних случаев, частоту и долю ошибок. Затем выбирают одну главную метрику и одну контрольную, задают окно замера и правило «стоп, доработать или масштабировать». После пилота ту же метрику считают тем же способом. Без записи «до» результат превращается в мнение.
Какие метрики использовать для оценки эффекта ИИ?
Метрики берут под цель пилота, а всего их удобно держать 24 в пяти группах. Финансовые: выручка, затраты, окупаемость, ROI, цена операции. Операционные: скорость цикла, доля задач без человека, время, ошибки. Ещё есть клиентские, кадровые и контрольные. На один пилот хватает одной главной и одной контрольной метрики.
Как посчитать ROI внедрения ИИ?
ROI внедрения ИИ считают по формуле (выгода − вложения) / вложения × 100 % отдельно для каждой задачи. Во вложения входят лицензии, токены, интеграция, обучение и время людей на проверку ответов ИИ. По KPMG (2026), доказанный возврат вложений есть у 15 % компаний, которые видят все затраты на ИИ. У остальных у 3 %. Средний ROI по всем проектам прячет убыточные.
Сколько длится пилот, чтобы увидеть результат?
Первые результаты по скорости и времени видны за 1–3 месяца. Ошибкам, доле задач без человека и оценкам клиентов нужно 3–6 месяцев. Удержание клиентов и повторные продажи проявляются через 6–12 месяцев. Срок пилота задают под главную метрику. Медленную метрику на первом месяце мерить нельзя: пилот закроют раньше, чем появится эффект.
Почему пилоты ИИ не дают результата?
Пилоты ИИ чаще всего не дают результата, потому что заранее не договорились, что считать. По опросу «Интеллектуальной аналитики» (2026), 30–40 % пилотов генеративного ИИ в крупных компаниях России свернули без ожидаемого финансового эффекта. Главная причина, по данным опроса, — слабая встройка в бизнес-процессы. В моей практике есть ещё одна: в расчёте эффекта нет прогона на реальных примерах.
Что делать, если эффект от ИИ не виден?
Если эффект не виден, сначала проверяют метрику. Модель потом. Может быть, эффект медленный и окно замера короткое. Может быть, нет точки отсчёта или часы сэкономили, но в новую работу не перевели. Затем считают время на проверку ответов ИИ. Если выигрыш после этого меньше 15 %, задачу меняют на другую.